Anthropic випустила Claude Fable 5.1 з рекордним результатом на науковому бенчмарку
Claude Fable 5.1 made me a really nice animated pelican
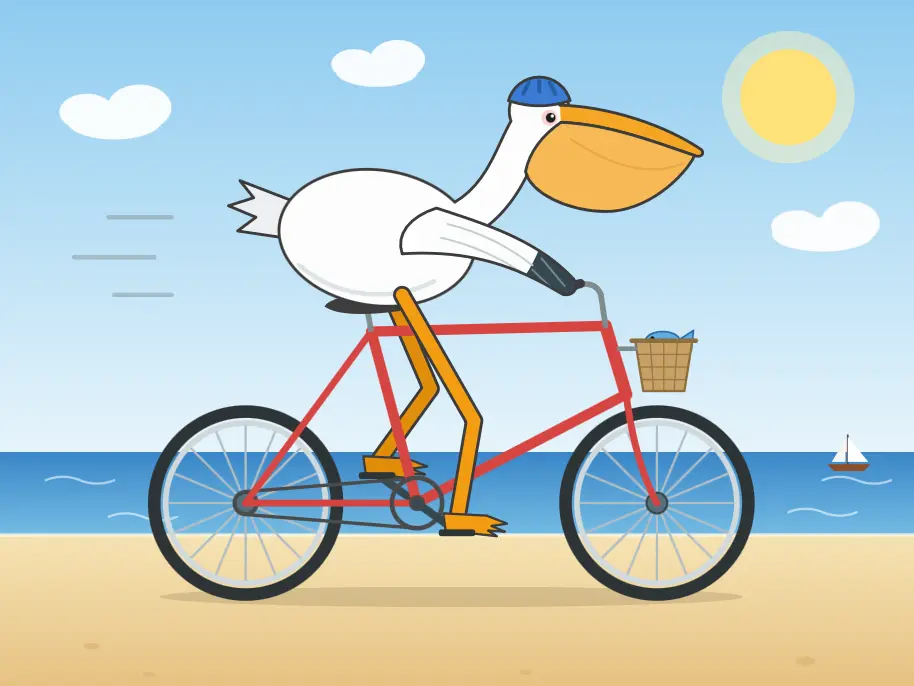
Anthropic представила модель Claude Fable 5.1, яка, за словами компанії, задає новий стандарт у програмуванні та науковій роботі: 52,6% на новому бенчмарку Terminal-Bench-Science 0.1 проти 24,7% у Fable 5, 29,0% у Opus 5 і 22,4% у GPT-5.6 Sol. Розробник Саймон Віллісон протестував модель своїм жартівливим «пелікан-бенчмарком» — генерацією SVG пелікана на велосипеді — на п'яти рівнях міркувань і виявив, що якість малюнка помітно зростає лише на найвищих рівнях, коштуючи значно дорожче. Найкращий результат на рівні «max» обійшовся у 3,30 долара і зайняв майже 14 хвилин генерації.
Мовою оригіналу · EN
Anthropic released Claude Fable 5.1, claiming a new standard for coding and scientific work with a 52.6% score on the Terminal-Bench-Science 0.1 benchmark, well above Fable 5, Opus 5, and GPT-5.6…
Читати оригінал на Simon Willison (AI/агенти) →
Чому в стрічці: Конкретний AI-реліз із бенчмарками та практичним тестом — відповідає інтересу до розробок ШІ.